01
단일 컨테이너에 인증만 덧붙이지 않고 층을 나눴습니다
- 고른 것
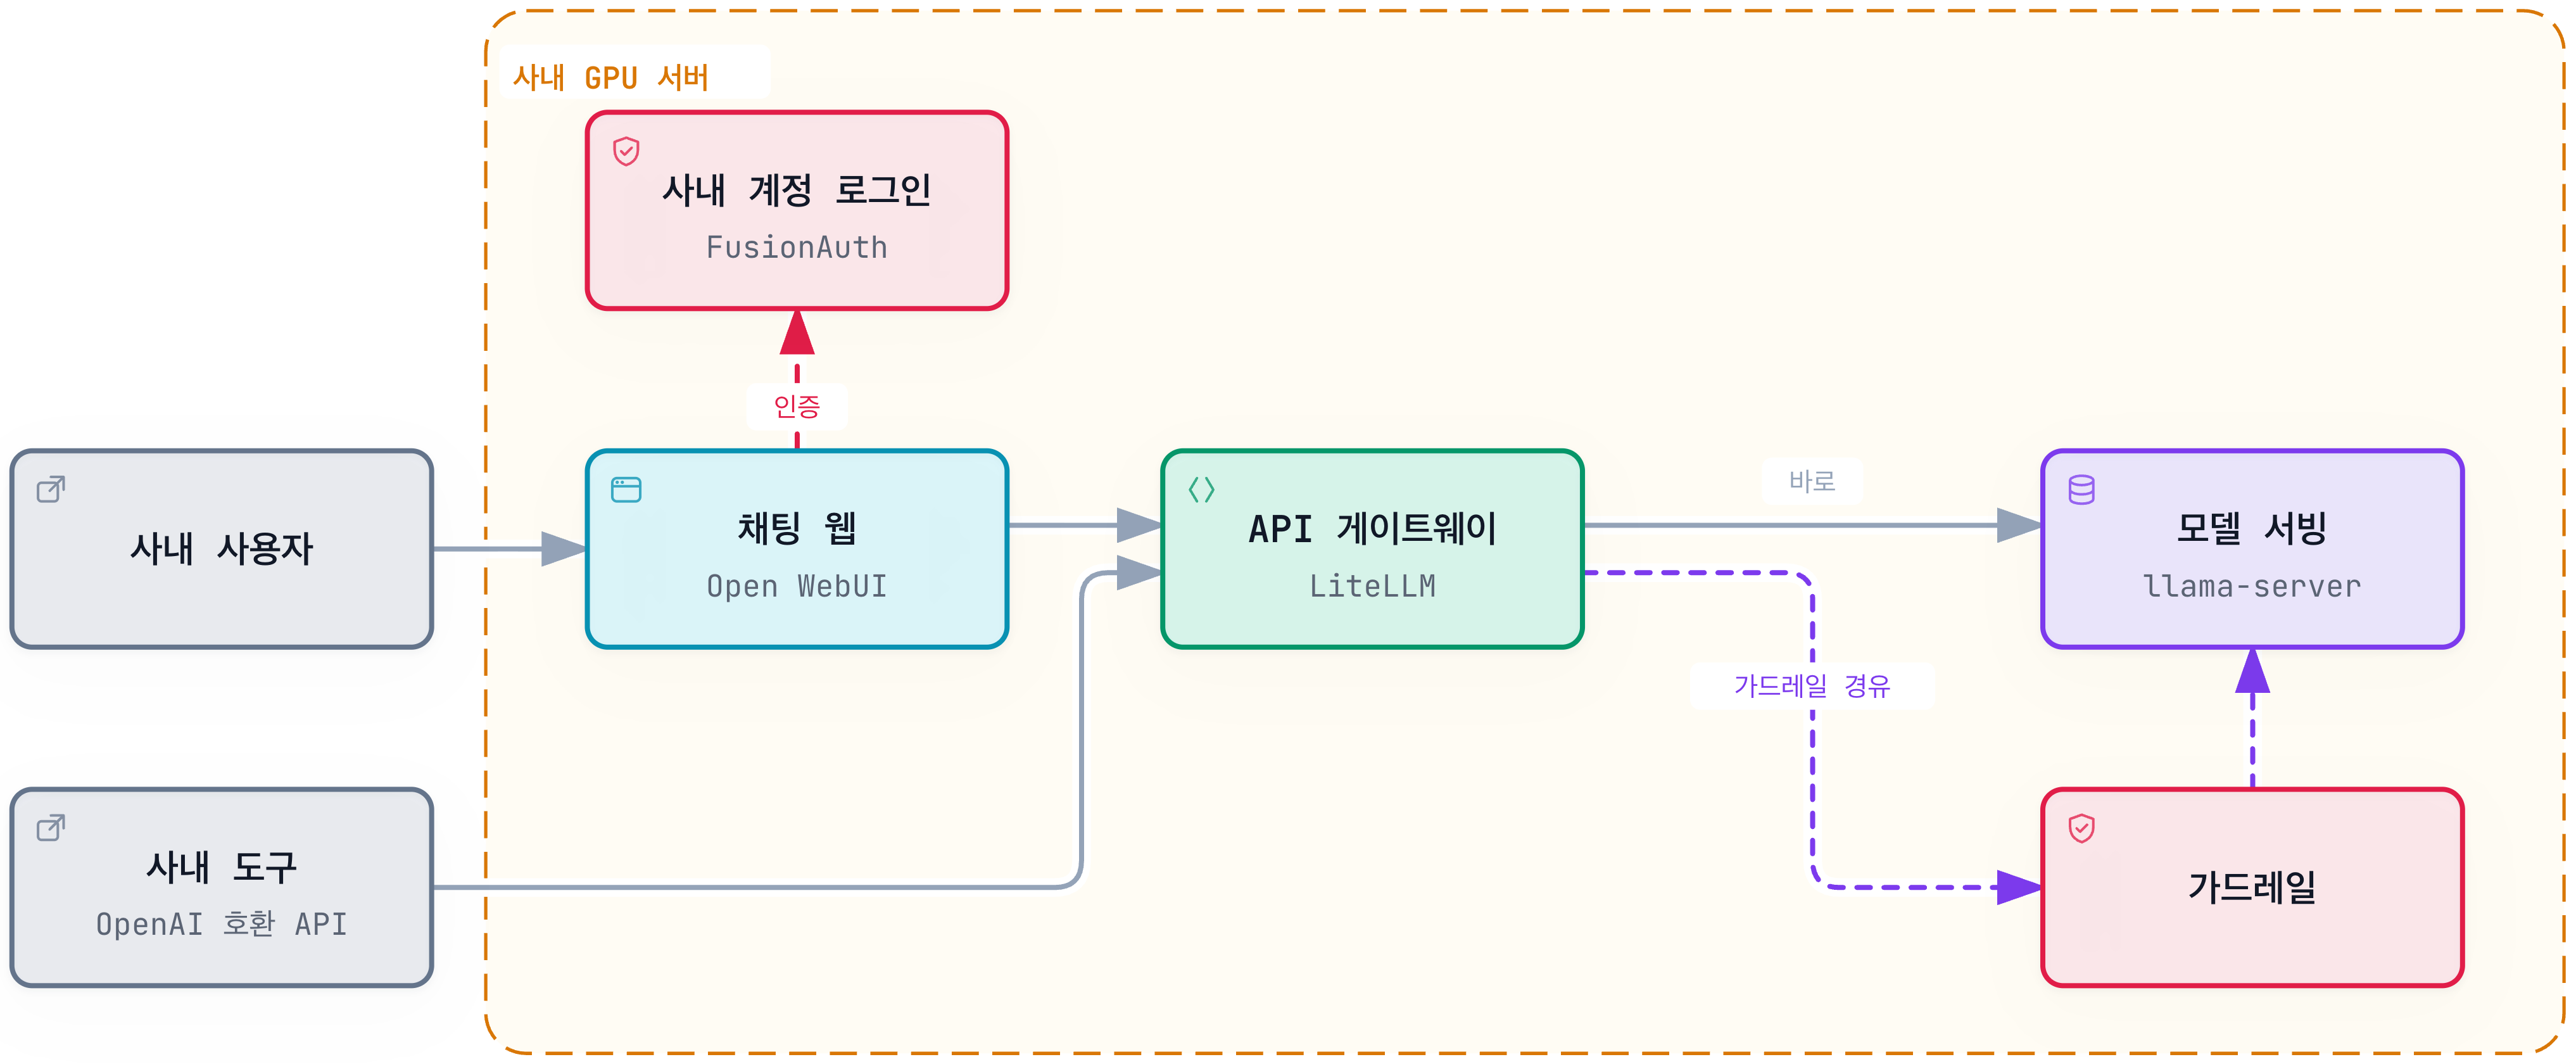
- 화면(Open WebUI), 게이트웨이(LiteLLM), 모델 서빙(llama-server), 가드레일을 따로 나눴습니다. 문제가 생긴 층만 따로 고치고 바꿀 수 있게 하기 위해서입니다.
- 구현과 테스트
- Docker Compose 구성, 연동 코드, 권한별 차단 테스트는 AI 코딩 에이전트가 만들고 돌리게 했습니다. 이 테스트로는 보이지 않던 결함은 직접 써 보다 찾았습니다(아래 03).
02
GPU 한 장에 세 모델을 올리려고 문맥 길이와 동시 처리를 줄였습니다
- 상황
- 생성 모델 1종과 가드레일 모델 2종을 GPU 한 장에 함께 올려야 했습니다.
- 고른 것
- 100,000 토큰까지 시험한 문맥 길이를 65,536 토큰으로 되돌리고 GPU가 한 번에 요청 하나만 처리하게 해 메모리 부족(OOM)을 막았습니다.
- 감수한 것
- 동시 처리량이 줄어드는 것은 감수했습니다.
03
한 번 거절되면 그 채팅이 계속 막히던 결함을 고쳤습니다
- 문제
- 가드레일에 한 번 걸리면 그 채팅에서는 이후 질문까지 계속 막혀 대화를 이어 갈 수 없었습니다.
- 원인
- Open WebUI가 거절된 질문을 대화 기록에 남겨 다음 요청마다 같은 질문이 함께 가드레일 검사로 넘어갔습니다.
- 해결
- 거절된 질문은 대화 기록에서 빼고 새로 입력한 메시지만 가드레일 검사를 거치게 해, 차단 뒤에도 같은 채팅을 이어 갈 수 있게 했습니다.
04
사내 계정으로 로그인하고 권한에 따라 경로를 나눴습니다
- 고른 것
- 사내 SSO(FusionAuth)로 로그인하게 하고 승인된 사용자는 모델을 바로 호출하고 일반 사용자는 가드레일 검사를 거치도록 경로를 나눴습니다.
- 지금 상태
- 아직 전사에 연 서비스가 아닌 시험 환경이며 지금은 가드레일 관련 사업을 검토하는 데 씁니다. 운영 문서와 인수 문서를 남겼습니다.
05
고객 문의 분류는 자동 확정 대신 힌트로 두었습니다
- 상황
- 지금 구성으로 바꾸기 전에 같은 GPU 서버에 판정 전용 오픈소스 모델(Kev)을 올려 고객 문의의 서비스, 유형, 긴급도를 예측해 봤습니다.
- 결과
- 원문 전송을 승인한 31건 중 응답 오류 1건을 뺀 30건에서 셋 모두 맞은 것이 질문 방식에 따라 1~4건이었습니다.
- 고른 것
- 자동 확정은 하지 않고 사람이 확정할 때 참고하는 힌트로만 두었습니다.